从“死记硬背”到“自主干活”:一文看懂 AI 的演进、主流品牌优劣与未来走向
我们平时打开手机修图、让软件自动生成会议纪要,或者用聊天机器人查资料时,人工智能(AI)其实已经在后台完成了成百上千次计算。过去几年里,大家明显感觉到 AI 变聪明了:它不再只是机械地回复“听不懂您的意思”,而是能真正帮人写代码、做表格、甚至规划出差行程。 为什么 AI 会在短短几年内发生这么大的变化?市面上五花八门的 AI 工具到底哪家强?未来几年它又会把我们的工作和生活带向哪里?这篇文章就用最直白的话,带你把这三件事理清楚。
一、 AI 是怎么变聪明的?三个关键阶段
很多人以为 AI 是最近两年才突然冒出来的技术,其实科学家早在上世纪中叶就开始琢磨这件事了。如果把 AI 的成长过程比作人类学习,它大致走过了三个阶段:
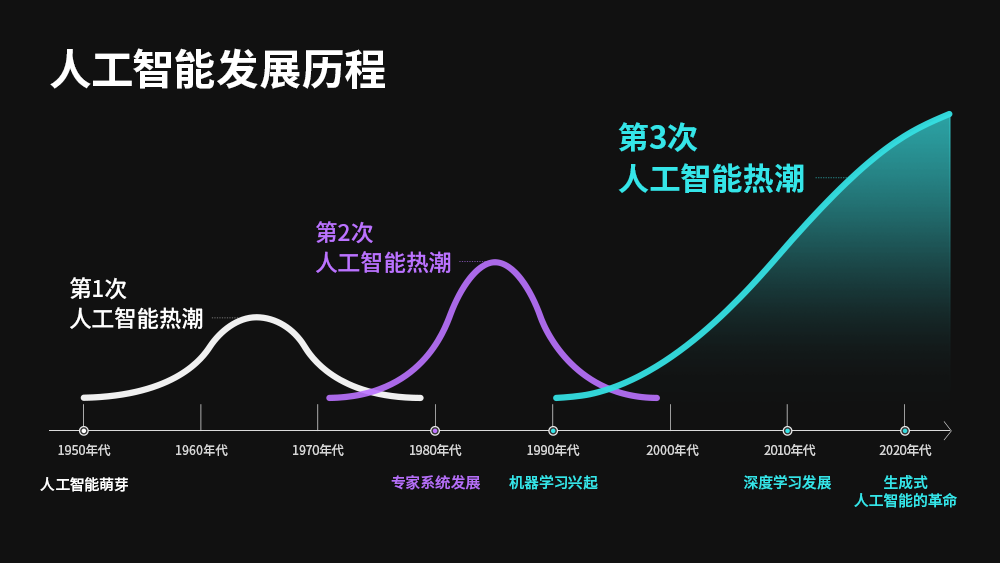 图 1:人工智能从早期规则系统到现代大模型的演进历程
flowchart LR
    A[第一阶段:1950s-1990s<br/>专家系统与逻辑规则<br/>人类写死规则,机器按步执行] --> B[第二阶段:2000s-2010s<br/>机器学习与深度学习<br/>给机器喂海量数据,自己找规律]
    B --> C[第三阶段:2020s至今<br/>生成式大模型与智能体<br/>跨模态理解生成,自主调用工具]
1. 第一阶段:靠人“死记硬背”写规则(20世纪50年代—20世纪末)
1956年的达特茅斯会议正式提出了“人工智能”这个词。那时候的科学家是怎么教电脑做事的呢?答案是靠人工一条条写规则,也就是“如果遇到情况 A,就执行动作 B”。
这种办法在下国际象棋或者做数学题时很管用,因为棋盘和公式的规则是固定的。但一旦放到现实生活里——比如让电脑认出一张照片里是不是猫——这套办法就彻底失灵了。因为猫有各种姿势、毛色和光线角度,人类根本没办法用几万条死板的文字规则把“猫长什么样”写清楚。受限于当时的电脑算力和思路,AI 经历了好几次研发停滞期。
2. 第二阶段:让机器自己从数据里“找规律”(21世纪初—2010年代)
既然人类写不出所有规则,那能不能让电脑自己看图总结规律?随着互联网普及和显卡(GPU)计算能力的提升,科学家换了一条路:模拟人脑神经元的工作方式,搞出了“深度学习”。
研究人员不再告诉电脑“猫有尖耳朵和胡须”,而是直接把几百万张贴好标签的猫狗照片喂给电脑,让它在无数次猜错和纠正中自己总结特征。2016年,谷歌旗下的 AlphaGo 击败了围棋世界冠军李世石,靠的就是这种自我学习和强化训练的方法。也是在这个阶段,我们手机上的人脸解锁、语音转文字、拍照翻译等功能开始真正好用起来。
3. 第三阶段:从“看懂听懂”到“自己创作与干活”(2020年代至今)
真正让普通人每天都能用上 AI 的转折点,源于 2017 年谷歌研究团队发表的一篇关键论文《Attention Is All You Need》,他们提出了 Transformer 架构(Vaswani et al., 2017)。简单来说,这种新架构让电脑在处理长篇文字时,能够像人一样抓住上下文里的重点词,并且可以同时并行处理海量信息。
到了 2022 年底 ChatGPT 发布,大家发现当模型读完了几乎整个互联网的公开文字后,它不仅能流畅聊天,还能写文章、编代码、画图(即“生成式 AI”)。而在最近一两年里,AI 又往前迈了一步——从单纯“陪聊”变成了能主动帮人干活的 AI 智能体(Agent)。你只要给它一个目标,它就能自己拆解步骤、上网查资料、调用软件接口,把整套活儿干完。
二、 现阶段主流 AI 品牌:谁更适合你?
弄明白了技术是怎么来的,我们再来看看现在市面上最主流的几家 AI 品牌。我在日常做文献整理、写代码和测试多模态功能时,经常会把这几家的产品放在一起对比。它们并没有绝对的“谁完胜谁”,因为每家公司的技术重心完全不同。
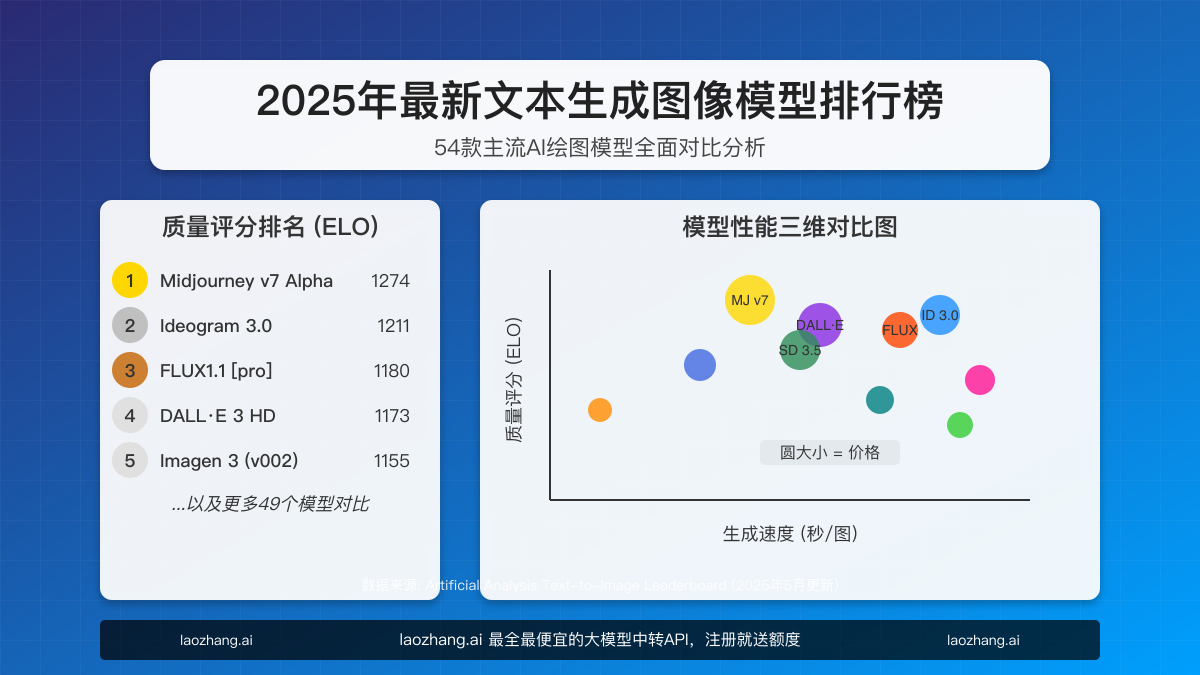 图 2:不同生成式 AI 模型在文本、图像与综合任务上的能力分化
为了方便直观对比,我们可以把目前全球主流的 AI 品牌分为四个代表阵营:
| 品牌与代表产品 | 核心特点 | 实际使用中的优势 | 现阶段的明显短板 |
|---|---|---|---|
| OpenAI<br>(ChatGPT / GPT-4o / o系列) | 综合实力最均衡的探路者 | 1. 功能最全面:语音对话、识图、写文案、深度推理样样精通,几乎没有明显偏科。<br>2. 上手门槛极低:大众用户最多,周边插件和应用生态最丰富。 | 1. 高级功能收费贵:高阶推理模型和重度使用套餐对个人用户来说成本不低。<br>2. 闭源黑盒:企业如果想把数据放在自己本地服务器上私有化部署,很难直接用它。 |
| Google<br>(Gemini 系列 / AlphaFold) | 背靠搜索与科研体系的巨头 | 1. 超长上下文与多模态:能一次性塞进几百页 PDF 文档或直接上传长视频让它分析。<br>2. 生态绑定深:和安卓系统、Google 搜索、办公套件结合紧密,且在生物医药等科研领域(Jumper et al., 2021)处于领先地位。 | 1. 中文语境偶有生硬感:在处理中文长文写作时,表达有时候不如专门针对中文优化的模型地道。<br>2. 产品入口多且杂:不同版本的命名和入口经常调整,新手容易看花眼。 |
| Anthropic<br>(Claude 系列) | 程序员与文字工作者的心头好 | 1. 代码与长文能力极强:在实际测试中,它写代码的准确率、修改大型项目的能力,以及写文章时的“自然人味”往往最受好评。<br>2. 安全性高:非常注重输出内容的合规与安全,深受海外企业客户信赖。 | 1. 生态相对单一:早期不直接提供画图或视频生成功能,更偏重文本与代码生产力。<br>2. 账号风控严格:对网络环境和注册地区要求严苛,普通用户高频使用时容易遇到调用次数限制。 |
| 开源与中国大模型阵营<br>(DeepSeek / 阿里通义千问 Qwen / Meta Llama) | 高性价比与本地化落地的实干派 | 1. 成本极低且开源:像 DeepSeek 和 Qwen 把模型权重公开,企业和个人甚至可以在自家电脑或服务器上免费部署,API 调用价格也只有海外闭源模型的几分之一。<br>2. 懂中文、接地气:对中文互联网梗、公文格式、本土业务场景的理解远超海外模型。 | 1. 顶尖算力受限:在获取最先进的算力芯片上面临外部限制,需要靠算法优化来弥补硬件差距。<br>2. 部分复杂多模态仍在追赶:在原生音视频实时交互、超大规模物理世界模拟等前沿方向上,仍在快速迭代追赶中。 |
日常选型小建议:如果你平时主要写代码、改长文,可以优先试试 Claude 或 DeepSeek;如果需要一次性分析几十份参考资料、看长视频,Gemini 会非常省心;如果想要一个全能语音助手,ChatGPT 依然顺手;如果是国内企业想做内部知识库又怕数据泄露,直接本地部署开源的 Qwen(通义千问) 或 DeepSeek 是最划算的方案。
三、 全球 AI 发展的未来预期:接下来会发生什么?
看清了现在的格局,大家最关心的问题自然是:未来五到十年,AI 还会怎么变?结合目前学术界和工业界的真实研发动向,接下来全球 AI 的演进主要集中在以下四个看得见的方向。
图 3:AI 正从电脑屏幕里的软件,走向与物理世界结合的具身智能与商业自动化
graph TD
    subgraph 全球AI未来四大演进方向
    D1[1. 从聊天框走向自主智能体<br/>跨软件自动执行复杂工作流]
    D2[2. 走向物理世界:具身智能<br/>人形机器人与自动驾驶落地]
    D3[3. 深入基础科学:AI for Science<br/>加速新药研发与新材料筛选]
    D4[4. 破解算力与电力瓶颈<br/>小模型端侧部署与绿色能源配套]
    end
1. 软件层面:从“聊天框”变成后台自动干活的“数字同事”
现在的 AI 大多还需要我们守在电脑前,你问一句、它答一句。但接下来的核心趋势是 智能体工作流(Agentic Workflow)。未来的操作系统和办公软件里,AI 会直接接管跨软件的操作。比如你对电脑说一句:“帮我把这周收到的所有客户报价单汇总成一张表格,标出最低价,再给对方发邮件确认。”AI 就会自己打开邮箱、下载附件、写入表格并起草邮件,你只需要在最后点一下“确认发送”就行。
2. 硬件层面:走出屏幕,进入物理世界(具身智能)
长久以来,AI 都像是一个“装在缸里的大脑”——它能写诗算题,却连端一杯水都做不到。现在,大模型正在和机器人硬件结合,也就是常说的 具身智能(Embodied AI)。无论是自动驾驶汽车,还是工厂里搬运货物的双足机器人,都在用大模型来理解周围的物理环境。过去机器人换个零件位置就不会抓了,而接入视觉语言大模型后,机器人能自己看懂环境变化并调整动作,这会让智能制造、仓储物流甚至未来的家庭养老发生实实在在的改变。
3. 科研层面:成为科学家的“超级显微镜”
除了帮普通人提高效率,AI 对人类社会更深远的影响其实在实验室里。过去研发一种新药,科学家往往需要在实验室里做几万次枯燥的试错,耗时十几年。而像 AlphaFold 这样的科学大模型(Jumper et al., 2021),已经帮全球生物学家预测出了数亿种蛋白质的三维结构。未来在寻找新型电池材料、预测极端天气、辅助气象建模以及医疗影像筛查上,AI 都会成为科学家的标配工具。
4. 能源与落地层面:“省电的小模型”与绿色算力并重
很多人不知道,AI 其实是个“电老虎”。根据国际能源署发布的报告(International Energy Agency [IEA], 2024),随着全球数据中心大规模扩建,AI 带来的电力消耗正在急剧攀升,每一次向大模型提问耗费的电量都远高于普通的网页搜索。
为了解决“算力贵、耗电高”的问题,未来的 AI 发展正在走两条非常务实的路线:
- 一方面,大型科技公司都在把数据中心建在风能、太阳能、水电丰富的地区,或者探索核能供电;
- 另一方面,技术圈不再一味追求“模型越大越好”,而是致力于把模型压缩变小,直接塞进我们的手机和笔记本电脑芯片里(即 端侧 AI)。这样平时处理日常修图、语音转写和本地文件搜索时,根本不用联网去跑云端大模型,既保护了个人隐私,又省下了高昂的电费和算力成本。
结语
回顾 AI 走过的这几十年,它从最初只能按死板规则下棋的程序,变成了今天能读懂文章、写代码、甚至驱动机器人的实用工具。面对这场技术浪潮,我们既不需要把它神化成无所不能的魔法,也不必过度焦虑自己会被机器彻底取代。
真正拉开人与人之间差距的,往往不是 AI 本身,而是谁能更快摸清不同 AI 工具的脾气,把那些重复、琐碎的机械劳动甩给它,从而把自己的精力留给真正需要思考、审美和人际沟通的事情上。
参考文献(APA 格式)
- International Energy Agency. (2024). Electricity 2024: Analysis and forecast to 2026. IEA Publications.
- Jumper, J., Evans, R., Pritzel, A., Green, T., Figurnov, M., Ronneberger, O., ... & Hassabis, D. (2021). Highly accurate protein structure prediction with AlphaFold. Nature, 596(7873), 583-589.
- Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., Kaiser, Ł., & Polosukhin, I. (2017). Attention is all you need. Advances in Neural Information Processing Systems, 30, 5998-6008.